Hvor dataene deres havner når en AI-agent svarer
Av Team Two · Sist oppdatert 23. september 2026 · 3 min lesing
«Alle data blir i EU» er en av de vanligste påstandene i markedsføring av AI-programvare. For de fleste produkter som bruker de mest avanserte modellene, stemmer det ikke helt, og personvernombud vet det.
Vi forklarer heller nøyaktig hva som skjer. Her er hvor dataene deres lagres, hva som sendes hvor når en agent svarer, og hva dere kan gjøre hvis noe av det aldri skal forlate deres egen infrastruktur.
Hvor dataene deres lagres
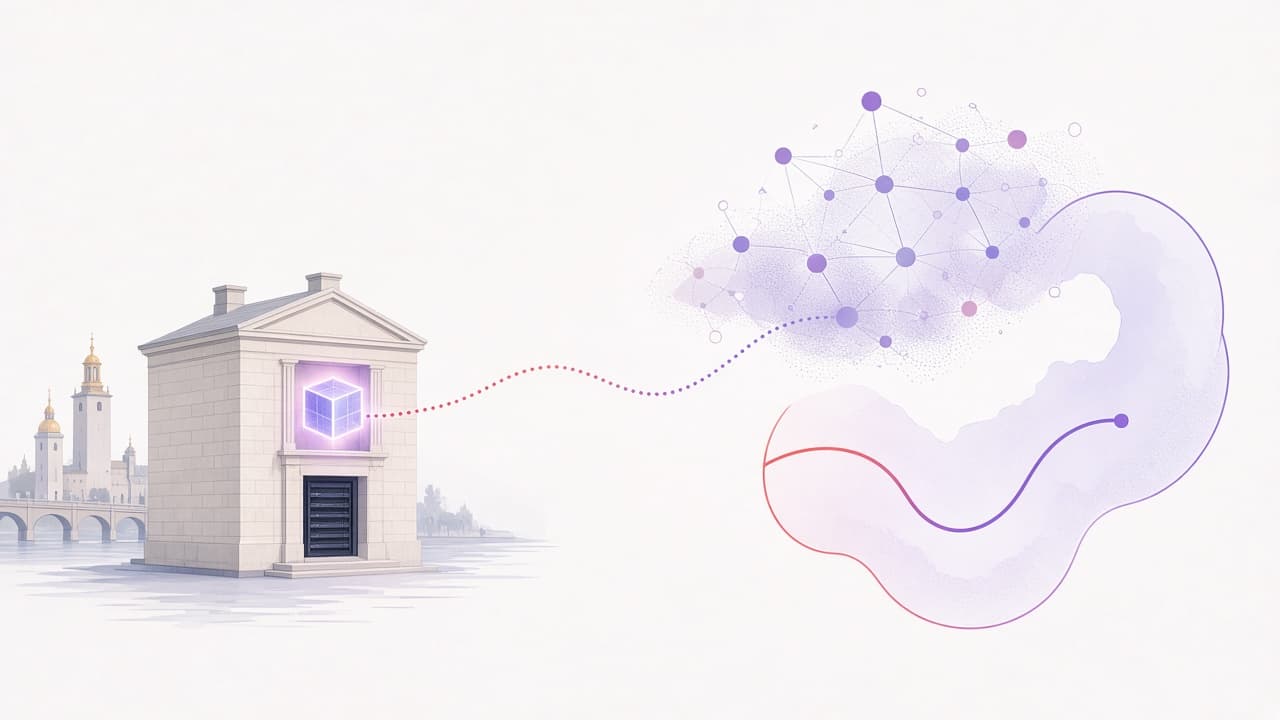
Team Two kjører på AWS i Stockholm (eu-north-1). Dataene i arbeidsområdet deres, inkludert dokumenter, søkeindeksen deres, samtaler, agentkonfigurasjoner og revisjonslogger, lagres der, kryptert ved lagring. Tilkoblinger er kryptert under overføring.
Hva som skjer når en agent svarer
For å lage et svar sender en agent en forespørsel til en språkmodell. Forespørselen inneholder agentens instruksjoner, den siste delen av samtalen og avsnittene som er hentet fra dokumentene deres. Hvis dere bruker en skymodell fra Anthropic eller OpenAI, behandles forespørselen av dem, i USA.
Noen andre steg involverer også eksterne tjenester:
- Dokumenter gjøres om til embeddings, en numerisk representasjon som brukes til søk, av en modelleverandør når dere laster dem opp.
- Hvis en agent bruker verktøyet for nettsøk, går søket til en leverandør av nettsøk.
- Fakturering går via Stripe.
Hver av disse leverandørene er oppført, med hva de gjør og hvor, på siden vår om underleverandører.
Hvordan disse overføringene er dekket
Overføringer til leverandører utenfor EU bygger på EU-kommisjonens standard personvernbestemmelser (Standard Contractual Clauses) og, der leverandøren er sertifisert, EU-US Data Privacy Framework. Vi bruker ikke dataene deres til å trene modeller, og avtalene våre med leverandørene gjelder API-bruk, der det dere sender inn heller ikke brukes til å trene deres modeller.
Til deres egen compliance-dokumentasjon signerer vi en databehandleravtale der dere er behandlingsansvarlig og vi er databehandler. Et sammendrag finnes på siden om underleverandører. Den fullstendige databehandleravtalen er tilgjengelig på forespørsel.
Alternativer hvis noen data aldri skal ut
For noen virksomheter, eller for noen typer arbeid, er ikke svaret over godt nok. Team Two gir dere tre spaker:
- Kjør en lokal modell. Team Two kan bruke en modell dere drifter selv med vLLM. Forespørsler til den modellen blir i deres egen infrastruktur.
- Bruk egne nøkler. Koble til deres egen Anthropic- eller OpenAI-konto, så modellkall kjører under deres egen avtale med leverandøren.
- Sett en policy. Gateway-innstillinger lar dere sperre skymodeller, tillate dem bare for bestemte agenter, eller tvinge sensitivt arbeid over på en lokal modell.
Dere kan kombinere disse. Et vanlig oppsett er en skymodell for generelle spørsmål og en lokal modell for agenter som håndterer HR- eller økonomidata.
Hva vi ville spurt enhver AI-leverandør
Uansett om dere velger Team Two eller ikke, skiller disse spørsmålene ærlige svar fra markedsføring:
- Hvor lagres dataene mine?
- Hvilke modelleverandører mottar promptene mine, og i hvilket land?
- Finnes det en publisert liste over underleverandører, og hvordan får jeg beskjed når den endres?
- Kan jeg bruke en lokal modell eller min egen leverandørkonto?
- Brukes dataene mine til trening, av dere eller av leverandørene deres?
Hvis en leverandør sier at ingenting noen gang forlater EU, men bruker en avansert modell som hostes i USA, be dem forklare hvordan.
Ofte stilte spørsmål
Er Team Two i samsvar med GDPR?+
Vi behandler personopplysninger i henhold til GDPR, signerer databehandleravtaler, publiserer underleverandørene våre og støtter de registrertes rettigheter. Etterlevelse avhenger også av hvordan dere bruker produktet. Se personvernerklæringen vår.
Kan vi bruke Team Two med bare modeller som hostes i EU?+
Ja. Dere kan kjøre en modell dere drifter selv, i EU eller i egne lokaler, og sette en policy som sperrer skymodeller.