Hvor jeres data sendes hen, når en AI-agent svarer
Af Team Two · Senest opdateret 23. september 2026 · 3 min. læsning
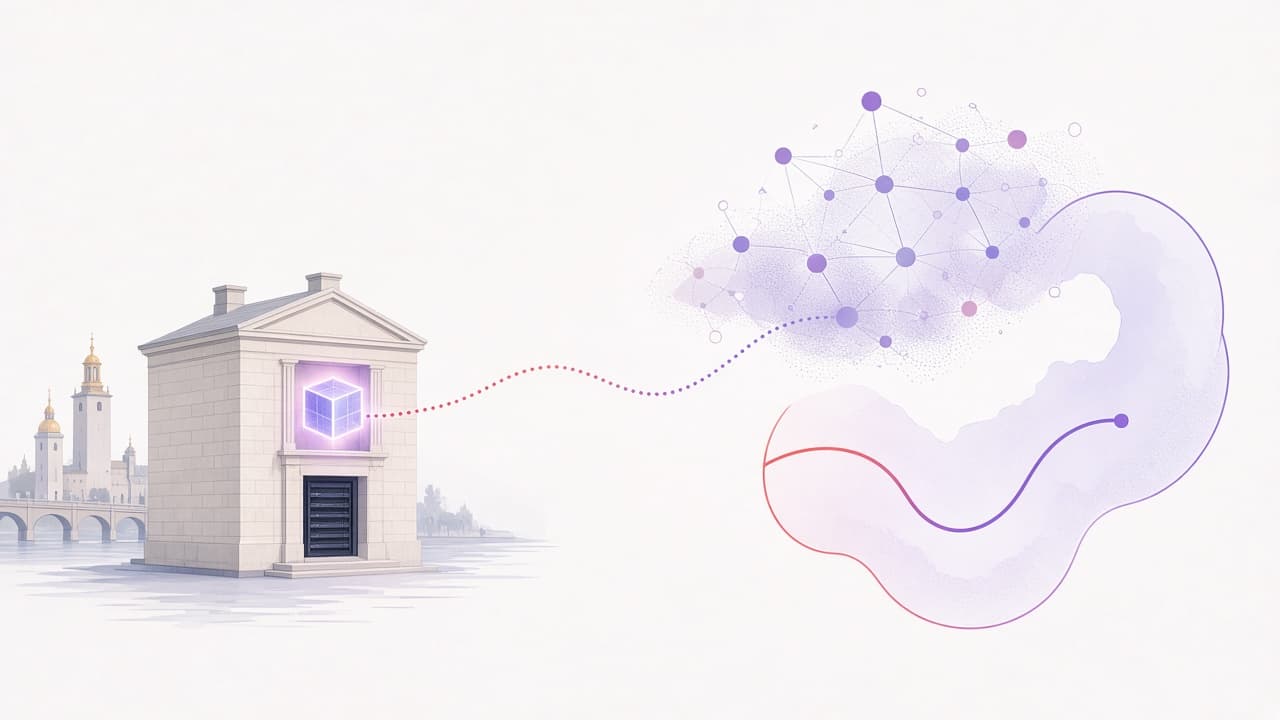
»Alle data bliver i EU« er en af de mest almindelige påstande i markedsføringen af AI-software. For de fleste produkter, der bruger frontiermodeller, er det ikke helt sandt, og databeskyttelsesrådgivere ved det.
Vi vil hellere forklare præcis, hvad der sker. Her kan I se, hvor jeres data gemmes, hvad der sendes hvorhen, når en agent svarer, og hvad I kan gøre, hvis noget af det aldrig må forlade jeres egen infrastruktur.
Hvor jeres data gemmes
Team Two kører på AWS i Stockholm (eu-north-1). Data i jeres workspace, herunder dokumenter, deres søgeindeks, samtaler, agentkonfigurationer og revisionslogge, gemmes der, krypteret i hvile. Forbindelser er krypteret under overførsel.
Hvad der sker, når en agent svarer
For at lave et svar sender en agent en forespørgsel til en sprogmodel. Forespørgslen indeholder agentens instruktioner, den seneste del af samtalen og de passager, der er hentet fra jeres dokumenter. Hvis I bruger en cloudmodel fra Anthropic eller OpenAI, behandles forespørgslen af dem, i USA.
Nogle andre trin involverer også eksterne tjenester:
- Når I uploader dokumenter, omdannes de af en modeludbyder til embeddings, en numerisk repræsentation, der bruges til søgning.
- Hvis en agent bruger værktøjet til websøgning, sendes søgeforespørgslen til en udbyder af websøgning.
- Betaling går gennem Stripe.
Hver eneste af disse udbydere står på vores side om underdatabehandlere med oplysninger om, hvad de gør, og hvor.
Hvordan overførslerne er dækket
Overførsler til udbydere uden for EU hviler på Europa-Kommissionens standardkontraktbestemmelser og, hvor udbyderen er certificeret, EU-US Data Privacy Framework. Vi bruger ikke jeres data til at træne modeller, og vores aftaler med udbyderne gælder API-brug, hvor jeres input heller ikke bruges til at træne deres modeller.
Til jeres egen compliancedokumentation underskriver vi en databehandleraftale, hvor I er dataansvarlige, og vi er databehandler. Et resumé findes på siden om underdatabehandlere. Den fulde databehandleraftale kan fås på anmodning.
Muligheder, hvis nogle data aldrig må forlade jer
For nogle virksomheder, eller nogle typer arbejde, er svaret ovenfor ikke godt nok. Team Two giver jer tre håndtag:
- Kør en lokal model. Team Two kan bruge en model, I selv hoster med vLLM. Forespørgsler til den model bliver inden for jeres egen infrastruktur.
- Brug jeres egne nøgler. Tilslut jeres egen Anthropic- eller OpenAI-konto, så modelkald kører under jeres egen aftale med den udbyder.
- Sæt en politik. Med gateway-indstillinger kan I forbyde cloudmodeller, kun tillade dem for bestemte agenter eller tvinge følsomt arbejde over på en lokal model.
I kan kombinere dem. En almindelig opsætning er en cloudmodel til generelle spørgsmål og en lokal model til agenter, der håndterer HR- eller økonomidata.
Det ville vi spørge enhver AI-leverandør om
Uanset om I vælger Team Two eller ej, skiller disse spørgsmål ærlige svar fra markedsføring:
- Hvor gemmes mine data i hvile?
- Hvilke modeludbydere modtager mine prompter, og i hvilket land?
- Findes der en offentliggjort liste over underdatabehandlere, og hvordan får jeg besked, når den ændres?
- Kan jeg bruge en lokal model eller min egen konto hos en udbyder?
- Bruges mine data til træning, af jer eller af jeres udbydere?
Hvis en leverandør siger, at intet nogensinde forlader EU, men bruger en frontiermodel hostet i USA, så bed dem forklare hvordan.
Ofte stillede spørgsmål
Overholder Team Two GDPR?+
Vi behandler personoplysninger i henhold til GDPR, underskriver databehandleraftaler, offentliggør vores underdatabehandlere og understøtter de registreredes rettigheder. Overholdelse afhænger også af, hvordan I bruger produktet. Se vores privatlivspolitik.
Kan vi bruge Team Two udelukkende med modeller hostet i EU?+
Ja. I kan køre en model, I selv hoster, i EU eller på egne lokaler, og sætte en politik, der forbyder cloudmodeller.